
GPT-6.1 Sol 完整解析:能力定位、实测方法与国内使用指南(2026)
本文摘要:本文根据 OpenAI 的 GPT-6.1 Sol 发布页,整理模型定位、官方评测、价格与可用性,并补充国内用户的实测方法和使用路线。文章开头提供两个可直接体验多模型的平台,但它们均为第三方服务。
开始前:两个可直接体验的中文平台
如果你只是想先体验多模型对话、文件处理或图片生成,可以先使用下面两个平台。它们属于第三方服务,和 OpenAI 没有隶属关系;使用前请阅读各自的隐私政策、额度规则和内容规范,不要上传密钥、客户资料或未脱敏代码。
1. LazyManChat:面向生产力的 AI 工作台
LazyManChat 定位为“个人 AI 生产力工具”,重点不是单一聊天窗口,而是 专业助手体系 + 知识库 + 插件生态。它适合需要把 AI 放进办公、学习、编程和创作流程的用户。
- 多模型支持:可在 ChatGPT、Gemini、Claude、Grok、DeepSeek 以及绘画模型之间切换,具体模型以平台当前列表为准。
- 400+ 专业助手:覆盖办公效率、学术研究、职业发展、文案创作、教育培训、编程开发、创意设计和生活服务等领域,也可以创建自己的助手。
- 知识库:支持上传 PDF、Word、Excel、PPT、Markdown 等文件,让回答围绕你的资料展开,适合做资料问答和内部知识整理。
- 插件与多模态:提供 Artifacts、思维导图、ArXiv/PubMed 搜索、网站爬虫、SEO 助手、AI 绘画、翻译、PPT 生成和联网等能力,实际可用范围以平台页面为准。
- 多端同步:支持 Web、桌面端、移动端和微信端,适合在不同设备之间继续工作。
更适合的用法是:先建立一个项目知识库,再给助手写清楚输出格式、引用范围和不能猜测的内容。这样比单纯追求“模型名称最新”更容易得到稳定结果。
2. Luck AI:轻量的多模型聊天与画图入口
Luck AI(也称 Luck AI 中文版)更偏向“打开即聊”。它提供多模型聊天和图片生成入口,适合写代码、读文件、创意写作和快速生成图片的日常任务。
- 支持 GPT 系列、Gemini、Claude、Grok,以及 GPT Image、Nano Banana Pro 等绘图模型,模型名称和额度以左上角当前列表为准。
- 界面结构简单:左侧是对话列表,右侧是聊天区,适合快速切换模型和继续历史对话。
- 提供周卡、月卡、年卡、积分体验卡和加油包等方案;“无限”“续杯”或高频使用条件应以购买页面的实时规则为准。
- 支持主题切换、下载安装和备用网址,遇到登录或额度问题可通过平台客服渠道核对。
- 平台通常会公布内容红线、账号使用和记录保存规则。不要把“对话保存 1 个月”等说明泛化到其他平台,也不要在第三方平台粘贴生产环境密钥。
这两个入口解决的是“如何快速开始”,不能替代官方文档、企业数据处理协议或 API 控制台。需要可审计的生产调用时,应优先走官方 API 或经过组织批准的服务商。
一句话理解 GPT-6.1 Sol
OpenAI 将 GPT-6.1 Sol 定义为 GPT-6 Sol 的升级版,重点面向智能体编程、计算机使用和专业工作。官方发布页的核心表述是:它在高难度任务上的表现更接近 GPT-6 Astra,而标准输入和输出 Token 价格约为 Astra 的五分之一。对使用者而言,最有价值的判断仍然是它在你的任务中能否稳定完成“理解上下文、制定步骤、调用工具或生成代码、检查结果”的闭环。
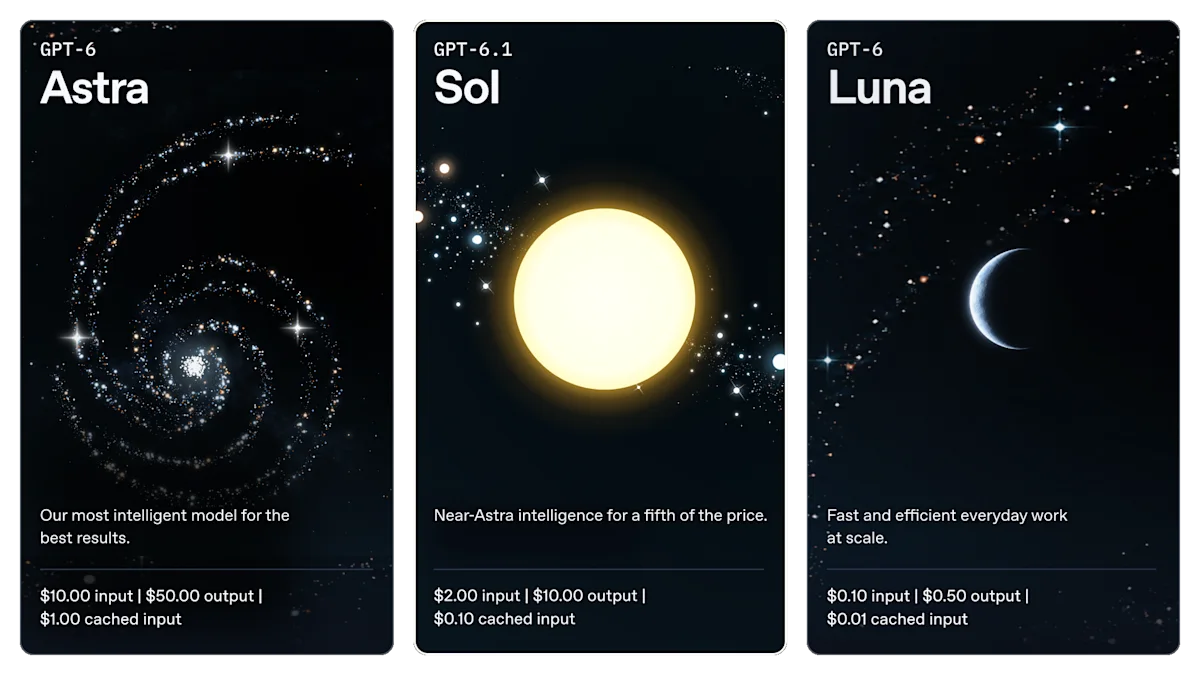
图:OpenAI GPT-6.1 Sol 发布页的模型卡片和价格对比图。来源:OpenAI。
截至该发布页,GPT-6.1 Sol 的标准 API 价格为:每百万输入 Token 2 美元、每百万缓存输入 Token 0.10 美元、每百万输出 Token 10 美元。官方同时说明,Plus、Pro、Business、Enterprise 和 Edu 用户可以在 ChatGPT 工作和 Codex 中使用该模型;API 模型 ID 为 gpt-6.1-sol。这些信息会随产品更新变化,接入前仍应以控制台为准。
官方发布页到底说了什么
下面的内容直接对应 OpenAI 发布页,而不是第三方平台宣传:
| 官方信息 | 发布页内容 | 阅读时的边界 |
|---|---|---|
| 模型关系 | GPT-6.1 Sol 是 GPT-6 Sol 的升级版 | 发布页的评测环境不等于所有 ChatGPT 会话 |
| 重点场景 | 智能体编程、专业工作、计算机使用和科学研究 | 具体效果受系统提示、工具和推理强度影响 |
| 成本定位 | 接近 GPT-6 Astra 的智能水平,标准输入/输出价格约为其五分之一 | “接近”是官方评测定位,不是每个任务的保证 |
| 缓存输入 | 每百万 Token 0.10 美元,官方称比标准输入价格低 95% | 需确认实际请求是否命中缓存 |
| 调用方式 | API 模型 ID 为 gpt-6.1-sol | 第三方平台显示名不一定等于真实模型 ID |
OpenAI 还特别注明,评估可能来自研究环境或 API;系统提示、可用工具和推理强度不同,结果可能与正式版 ChatGPT 输出不同。竞争模型数据取自其公开报告,因此不宜把这些图表当成统一实验室下的绝对排名。
编程:DeepSWE 1.1
DeepSWE 1.1 测试智能体在真实代码库中完成需要长程规划的软件工程任务。OpenAI 表示,GPT-6.1 Sol 以约五分之一的成本达到与 GPT-6 Astra 相当的水平,并比 GPT-6 Sol 的最高得分高 6.4 个百分点。

专业文档与业务工作流
在 GDP.pdf 评测中,模型需要阅读包含表格、图表、示意图和小字的复杂 PDF。OpenAI 称 GPT-6.1 Sol 在各档推理设置下均高于带回退机制的 Opus 5.5,并以约五分之一的单任务成本接近 GPT-6 Astra。

AutomationBench 1.0.6 测试销售、营销、运营、支持、财务和人力资源中的多步骤业务流程。官方报告称,GPT-6.1 Sol 在中等推理强度下比 Opus 5.5 高 2.2 个百分点,成本约为其三分之一;与相同设置的 GPT-6 Sol 相比高 4.8 个百分点。

计算机使用与科学研究
在 OSWorld 2.0 离线集上,GPT-6.1 Sol 最高推理强度的得分比 GPT-6 Sol 高 7 个百分点,成本不到其一半;与 Astra 的差距缩小到 2.1 个百分点以内,单任务成本约为 Astra 的七分之一。

Terminal-Bench Science 0.1 覆盖数据分析、模拟和定理证明。官方页面给出的最高推理强度平均单任务成本为:GPT-6.1 Sol 5.47 美元、Opus 5.5 23.21 美元、GPT-6 Astra 23.80 美元;Astra 仍以 68.1% 得分居首。

事实准确性与安全评估
在官方挑选的高难度提示中,GPT-6.1 Sol 超高推理强度的事实错误率为 4.1%,GPT-6 Sol 为 4.5%,GPT-6 Astra 为 4.0%。这组提示专门用于诱发错误,不代表典型使用中的错误率。

安全评估还测试了搜索工具故障时模型是否向用户说明问题。GPT-6.1 Sol 在 2.1% 的高难度样本中未披露故障,GPT-6 Sol 为 4.9%,GPT-6 Astra 为 1.5%,GPT-6 Luna 为 28.7%。同样,这是一组刻意挑选的压力测试样本。

本节图片均提取自 OpenAI GPT-6.1 Sol 发布页,文字结论按页面中文内容整理。图中成本和得分只对应官方注明的评测设置。
除了发布页已经公开的价格、模型 ID 和评测结果,其他参数仍应以 API 文档和控制台为准。实际选型时可以继续用三个维度验证它是否适合自己的任务:
| 维度 | 需要观察的行为 | 适合的结论写法 |
|---|---|---|
| 推理与规划 | 能否拆分约束、识别矛盾、按步骤完成任务 | “在本组任务中表现出更强/更弱的规划稳定性” |
| 长上下文与资料处理 | 能否从多份文件中找出证据,并准确回指原文 | “在样本文件和当前上下文长度下通过测试” |
| 工具与代码工作流 | 能否生成可运行代码、根据报错继续修复 | “完成了指定环境中的闭环”,而非“所有项目都可靠” |
这套表述能避免把一次顺利回答扩大成普遍承诺,也方便你在模型更新后重复测试。
能力解析:从宣传词回到可验证任务
1. 复杂问题:看过程是否可复核
不要只问一个知识题。准备一个有约束的任务,例如“根据三份会议纪要,列出冲突决策、证据段落、待确认事项,并输出一页执行清单”。评分时检查四点:是否遗漏要求、引用是否真实、冲突是否被隐藏、结论能否追溯到输入。
2. 编程任务:看修改范围和验证动作
给模型一个小型仓库或最小复现项目,要求它先阅读结构,再修改一个明确问题,最后运行测试并报告未解决项。不要只看补丁是否漂亮,还要检查:
- 是否修改了不相关文件;
- 是否保留了原有接口和边界条件;
- 是否真的运行了测试,而不是声称“已验证”;
- 测试失败时能否给出下一步,而不是掩盖失败。
3. 文档和写作:看事实纪律
要求模型写一份带来源的说明,同时提供两条故意缺失证据的陈述。好的结果应把“来源确认”“根据输入推断”“暂时无法确认”分开。对于价格、发布日期、地区可用性、系统要求等易变信息,必须保留官方链接和核验日期。
4. 多模态任务:看它是否真正使用了输入
上传一张包含表格、标注和小字的图片,让模型先转录关键字段,再回答问题。对比它的回答与原图,不要只根据语言流畅度评分。涉及合同、财务或医疗资料时,人工复核仍然是必要步骤。
一套可复现的 GPT-6.1 Sol 实测方法
第一步:固定环境
记录测试日期、入口(官方 ChatGPT、官方 API 或第三方平台)、模型 ID、系统提示、温度等可见参数、文件版本和网络状态。第三方平台若没有暴露完整参数,就把“平台默认配置”写进记录。
第二步:准备五类样本
建议每类准备 3—5 个任务,规模不要一开始就过大:
- 事实检索:给出 10 条材料,其中 2 条相互矛盾,要求标注证据。
- 结构化推理:加入限制条件、预算和例外情况,要求输出决策表。
- 代码修复:提供一个能运行但有边界错误的最小项目。
- 长文档问答:上传多份文件,问题答案分别位于不同章节。
- 拒答与安全:测试它是否会泄露提示词、编造凭证或执行危险命令。
第三步:统一提示词
每个模型使用同一份提示词,并明确输出格式。例如:
你是一个严谨的技术分析助手。
任务:根据提供的材料回答问题。
要求:
1. 先列出使用到的证据,标明文件名和段落。
2. 把“材料明确说明”“基于材料推断”“无法确认”分成三栏。
3. 不要补充材料之外的价格、日期、参数或政策。
4. 如果信息不足,先提出最多 3 个澄清问题。
输出:Markdown 表格 + 结论 + 风险提示。
第四步:按指标打分
可以用 0—2 分记录每项表现:准确性、完整性、遵循格式、引用可追溯性、工具执行、错误恢复、响应时间和成本。总分不是“模型排名”,它只说明模型在这组任务和这个入口中的表现。
第五步:保存失败样本
最有价值的往往是失败记录:错误答案、遗漏条件、错误工具调用、超时、额度耗尽和接口返回码。下一次换模型或换平台时,用同一批失败样本回归测试,比重新挑几个成功案例更有意义。
国内用户怎么用:先选入口,再核对链路
路线 A:官方 ChatGPT 或官方 API
适合需要官方账号体系、原始模型 ID、正式文档和可审计账单的用户。访问受限时,不要下载所谓“官方破解版”,也不要在陌生网页输入 OpenAI 密码或 API Key。官方入口和可用地区可能变化,以 OpenAI 当前页面为准。
路线 B:第三方多模型平台
LazyManChat、Luck AI 这类平台降低了注册、模型切换和文件处理的门槛。使用时至少核对:平台主体、隐私政策、数据保存期限、训练用途、会员自动续费、失败退款、模型实际名称和上下文限制。敏感资料先脱敏,重要结论再回到可审计来源复核。
路线 C:OpenAI-compatible API
如果平台提供兼容接口,配置时不要只改模型名。至少检查下面四项:
| 项目 | 核对方法 |
|---|---|
| Base URL | 使用服务商文档给出的完整路径,确认是否需要 /v1 |
| API Key | 使用专用、可撤销的 Key,不要提交到 Git 或聊天记录 |
| Model ID | 从控制台复制真实 ID,不要把展示名称当作 ID |
| 协议 | 确认是 Chat Completions、Responses 还是平台自定义协议 |
一个最小的环境变量示例:
export OPENAI_API_KEY="你的专用密钥"
export OPENAI_BASE_URL="服务商文档给出的地址"
调用前先发送低风险测试请求,确认返回模型、计费单位、请求 ID 和错误信息。不要用真实客户数据做第一轮联调。
常见错误与排查顺序
| 现象 | 优先检查 |
|---|---|
401 Unauthorized | Key 是否复制完整、是否已过期、是否绑定了正确项目 |
404 model not found | 模型 ID 是否真实存在、服务商是否只支持别名 |
400 invalid request | 协议字段、消息格式、工具参数是否匹配 |
429 rate limit | 额度、并发、区域限制和重试策略 |
| 回复很短或忽略文件 | 文件是否成功上传、上下文上限、平台是否做了摘要 |
| 速度突然变慢 | 高峰限流、模型路由变化、网络链路和服务商队列 |
排错时一次只改一个变量,并保存原始响应。不要用不断重试来掩盖配置错误,也不要把第三方平台的 5xx 直接归因于模型本身。
隐私、安全与内容边界
使用 GPT-6.1 Sol 或任何第三方入口时,建议把资料分成三层:公开资料可以直接测试;内部资料先去掉姓名、联系方式、订单号和密钥;生产机密资料只在组织批准的环境中处理。代码仓库至少清理 .env、SSH 私钥、云平台凭证和真实用户数据。
模型能生成看似合理的内容,不代表内容已经通过事实、版权、合规或安全审查。发布前要复核来源,运行代码前要检查命令和文件改动,涉及财务、医疗、法律或个人信息时应由具备资质的人做最终判断。
结论:怎样判断它是否值得用
如果你的工作是多轮分析、代码修改、资料整理或需要持续检查的复杂任务,GPT-6.1 Sol 值得用一组固定样本做对比;如果只是偶尔问答,模型名称本身通常不是决定因素。最稳妥的选择方法是:用同一提示词和同一资料跑完五类任务,记录失败样本、成本和隐私条件,再决定使用官方入口、第三方平台还是兼容 API。
不要把一次演示当成长期能力,也不要把“能访问”当成“适合上传所有资料”。模型更新后重新跑回归测试,才是这篇指南中最值得保留的使用习惯。
FAQ
GPT-6.1 Sol 的价格和上下文长度是多少?
OpenAI 发布页列出的标准 API 价格是每百万输入 Token 2 美元、每百万缓存输入 Token 0.10 美元、每百万输出 Token 10 美元。该发布页没有列出上下文窗口长度;上下文长度、速率限制和套餐权限应以 API 文档及控制台为准。
第三方平台显示的 GPT-6.1 Sol 一定是官方模型吗?
不能仅凭展示名称判断。应核对平台的模型 ID、来源说明、协议返回值和账单记录;如果平台没有提供这些信息,就把它当作平台内部路由名称。
国内用户应该选 LazyManChat 还是 Luck AI?
需要知识库、专业助手、插件和跨端工作流时,LazyManChat 更匹配;只想快速聊天、写作或画图时,Luck AI 更轻量。两者都应先用低风险资料试用,再决定是否购买会员。
可以把 API Key 直接粘贴到聊天窗口吗?
不建议。使用环境变量或密码管理器保存专用 Key,并为不同项目设置不同密钥和额度。发现泄露后立即撤销并重新生成。
实测结果能代表所有用户吗?
不能。结果受入口、模型 ID、系统提示、地区、时间、网络、文件和评分标准影响。公开实测时应附上日期、样本、提示词和失败案例。
参考来源
非官方说明
本文由 Codex 中文指南整理,非 OpenAI 官方文档,也不代表 LazyManChat 或 Luck AI 的官方承诺。模型能力、价格、可用地区、平台规则和数据处理方式会变化,请在实际使用前再次核验。